Google検索結果の自動取得で発生している「SERP汚染」と影響
Google検索結果の自動取得で起きた「SERP汚染」とは
2026年夏以降、Googleの検索結果ページ(SERP:Search Engine Results Page)をシステムや外部ツール経由で自動取得した際に、これまでとは全く異なる性質の異常が観測されるようになりました。業界内で「SERP汚染(Poisoned SERPs)」と呼ばれている現象です。
まず結論からお伝えすると、SERP汚染とは、自動取得された検索結果が「一見すると正常な検索結果の体裁を保っているにもかかわらず、通常であれば安定して上位に表示されるはずの常連サイト群が消失し、全く別のサイト群に入れ替わって返却される現象」を指します。さらに実際の取得データでは、検索クエリの一部の単語が無視され、残りの単語だけに反応した無関係なWebサイト群が並ぶ異常もあわせて観測されています。
※本記事では、実際に弊社で取得したSERP情報を活用したSERP汚染の分析を掲載しています。興味深い結果がでていますので、是非最後までお読みください。
この現象を理解するうえで重要なのは、従来から知られていた以下2つの事象との違いです。
- 従来のスクレイピング遮断との違い:
IPブロックやCAPTCHA認証によって通信エラーとなり「データが一切取得できなくなる状態」ではなく、システム上はエラーが出ず、タイトル・URL・スニペット(説明文)が揃った検索結果データが正常に返却されたように見える点。 - 一般的な検索スパム(SEOポイズニング)との違い:
悪意ある第三者が不正な手法でマルウェア配布サイト等を検索上位に紛れ込ませる攻撃ではなく、人間がブラウザで検索した画面と、ツールが機械的に取得したデータとの間で結果セットそのものが乖離している点。
Googleの検索結果データは、日々の検索順位計測だけに使われているわけではありません。SEOにおけるキーワード調査や、記事を執筆する前の「検索意図の把握」「競合サイトの傾向分析」において不可欠な基礎データです。
したがって、取得したSERP情報に不正確なデータが混入するこの問題は、順位チェックツールやSEO分析ツールはもちろんのこと、私ども株式会社アップラボが開発・提供しているAIライティングツール「OGAI」のように、検索結果の分析から記事生成までを自動化する領域にも直結する極めて重大な技術課題といえます。
2026年7月からの発生経緯とGOTOリンク問題との違い
今回のSERP汚染に至るまでには、2026年夏から段階的な変化がありました。時系列に沿って経緯を整理するとともに、先行して話題となった「GOTOリンク」問題との構造的な違いを明確にしておきましょう。
前提として、Googleは以前より検索スパムポリシー等で、Googleの明示的な許可なくランキング確認などを目的として機械生成トラフィックを送信する行為(自動化された検索やスクレイピング等)を禁止しています。2025年1月中旬には検索結果の表示にJavaScriptの実行を必須化するなど、ボットやスクレイピングに対する技術的な制限を段階的に強化してきました。また、生成AIの業務利用状況が急速に拡大し、多くのAIツールや分析システムがリアルタイムのWeb検索データを参照するようになったことも、検索エンジン側への自動アクセスが急増した背景として挙げられます。
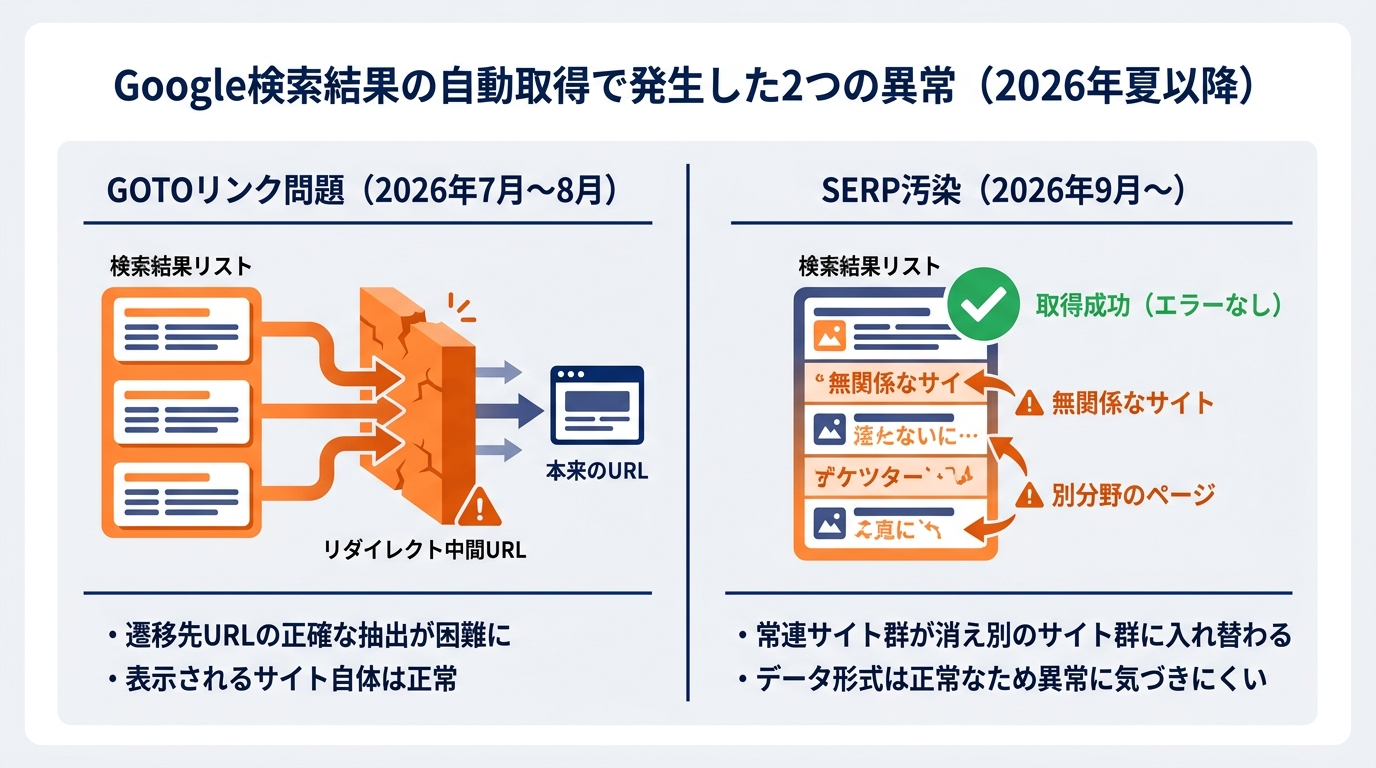
そうした中、2026年7月頃から海外のSEOツールベンダーや開発者の間で最初に報告されたのが「GOTOリンク」の導入です。これは8月に入りGoogleによる広範な展開が確認されました。GOTOリンクとは、検索結果内のリンク構造が直接の対象URLではなく、リダイレクト用のパラメータ等を含む中間URL(/goto?...などの形式)へ置き換えられる仕様変更です。
そしてその翌月、2026年9月以降に顕在化したのが「SERP汚染(Poisoned SERPs)」です。両者は時期が近いため混同されがちですが、引き起こされる問題の性質は根本的に異なります。
| 比較項目 | GOTOリンク問題(2026年7月〜8月) | SERP汚染(2026年9月〜) |
|---|---|---|
| 現象の概要 | 検索結果内のリンクがリダイレクト形式の中間URLに置き換わる | 自動取得された検索結果から通常の常連サイト群が消失し、別のサイト群(一部語句が無視された無関係なサイト等を含む)に置換される |
| 生じる問題の本質 | 遷移先となる「本来のURLの正確な抽出・解析」が技術的に困難になる | 検索結果に並ぶ「Webサイトの顔ぶれや順位そのもの」に異常が生じる |
| システム上の検知 | HTML構造やURL形式の変化として比較的検知しやすい | データ構造自体は正常なため、機械的なエラー検知をすり抜けやすい |
つまり、GOTOリンクが「URLの表記・取得方法に関するハードル」であったのに対し、9月以降のSERP汚染は「返却される情報の中身そのものが変わる」という、より深刻なフェーズへの変化であったといえます。
エラーが出ないため異常に気づきにくいという特徴
SERP汚染がWeb担当者やSEO実務者にとって非常に厄介なのは、「システム上でエラーが出ないため、異常が起きていることに気づきにくい」という点にあります。
従来のスクレイピング制限のように、通信が遮断されてエラーコードが返ってきたり、検索結果が空データになったりするのであれば、即座に「取得エラー」として認識でき、異常なデータがそのまま処理されることはありません。
しかしSERP汚染では、HTTPステータス200(正常終了)とともに、1位から10位、あるいは11位から20位までの「ページタイトル」「URL」「スニペット(概要文)」が欠損なく揃った形式で返却されます。プログラムによる単純な通信チェックでは「取得成功」と判定されてしまうものの、中身を精査すると以下のような異常が起きています。
- 検索したクエリの意図とは全く関係のないWebサイトが上位に並んでいる
- 実際のブラウザで検索した際には1ページ目に存在するはずの有力サイトが消えている
- クエリに含まれる一部の単語だけに反応したような、別分野のページが連続して表示されている
なお、Googleが自動取得(スクレイピング)対策として意図的にこのSERP汚染を実施しているのか、あるいは検索インフラやランキング処理の仕様変更に伴う副次的な挙動なのかについては、Googleから公式な発表や確認はなされていません。本記事では、公式に確認されていない背景の推測と、各社の調査および弊社の検証によって実際に観測された「事実(現象)」とを明確に区別して解説します。
調査データと独自検証で見るSERP汚染の具体的な実態
では、実際の検索結果データにおいて、どの程度の頻度で、どのようなサイトの入れ替わりが発生しているのでしょうか。海外のSEOツールベンダーによる調査事例と、株式会社アップラボが日本語環境(google.co.jp)で実施した独自検証データの双方から、SERP汚染の具体的な実態を明らかにします。
Nozzle社の調査で判明した検索結果の入れ替わりと発生率
SERP汚染の具体的な挙動をデータとともに報告した代表的な事例として、米国のエンタープライズ向け検索順位計測・SERP分析ツールを提供するNozzle社が2026年10月に公開(10月21日更新)した調査レポート(Google is Poisoning the SERPs)があります。
同社の調査では、過去の検索結果履歴において通常は毎回のように表示されている常連サイト群が1つも現れなくなる状態を「汚染(poisoning)」と定義して検出しています。さらに、常連サイトが消失するだけでなく、クエリの一部の語句が無視されて無関係なサイトが並ぶ極端な事例も報告されました。その典型例である「white label local seo」(ホワイトレーベルのローカルSEO代行・ツールに関するBtoB向け専門クエリ)の定点調査では、2026年10月4日の検索結果に表示されていた9つのWebサイトが、わずか3日後の10月7日にはすべて別のサイトに入れ替わっていたことが判明しています。
| 状態(取得日) | 上位に表示された主なサイトの種類 | 検索意図との整合性 |
|---|---|---|
| 正常時(2026年10月4日) | ローカルSEOの分析ツールや代行サービスなど計9サイト | ローカルSEOのプラットフォームや代行サービスを提供する専門サイトが並び、検索意図と完全に合致。 |
| 異常時(2026年10月7日) | WordPress開発ツール、地域情報サイト、掲示板、保健機関、政府機関など | WordPressのローカル開発環境ツール、地域情報、掲示板、全米郡市保健当局協議会、米国政府公式ポータルなど、「local」等の単語を含むだけの無関係なサイト群に置換。 |
10月7日のデータでは、本来上位にあるべきSEO関連の常連サイトがすべて姿を消しただけでなく、「white label」や「seo」という重要な語句が無視され、「local」という部分的な文字列のつながりだけで抽出されたような政府機関や保健機関のサイトなどが上位を占めていました。
同社の2026年10月21日更新版の集計(9月13日〜10月20日対象)によると、取得されたSERPにおける汚染の発生割合は以下の通り報告されています。
- 1ページ目のみにおける汚染率:平均 8.7%
- 1ページ目・2ページ目のいずれかに汚染が認められた割合:平均 22.6%(ピークとなった9月30日には 43.5% に到達)
【実データで検証】日本語50クエリでの弊社独自調査とページ別の異常傾向
日本語の検索環境でも同様の現象が起きているのかを確認するため、株式会社アップラボでは2026年10月22日、弁護士業務に関する50種類の日本語キーワード(離婚、相続、交通事故、労働問題、債務整理、企業法務など)を使い、Google検索結果を外部ツール経由で自動取得する独自検証を実施しました。
取得条件はgoogle.co.jp、日本語、検索地域を東京、デスクトップに統一し、キャッシュを使用しない設定(no_cache)としました。検索結果の1ページ目(取得開始位置start=0)と2ページ目(start=10)を別々に取得し、50キーワードで取得した自然検索結果(合計1,000件)のタイトル・URL・概要文を精査した結果、1ページ目と2ページ目で検索意図に合わない結果が現れる頻度に大きな差が確認されました。
| 取得位置 | 検索意図と明確に合わない結果が見られたクエリ | その他の判定 |
|---|---|---|
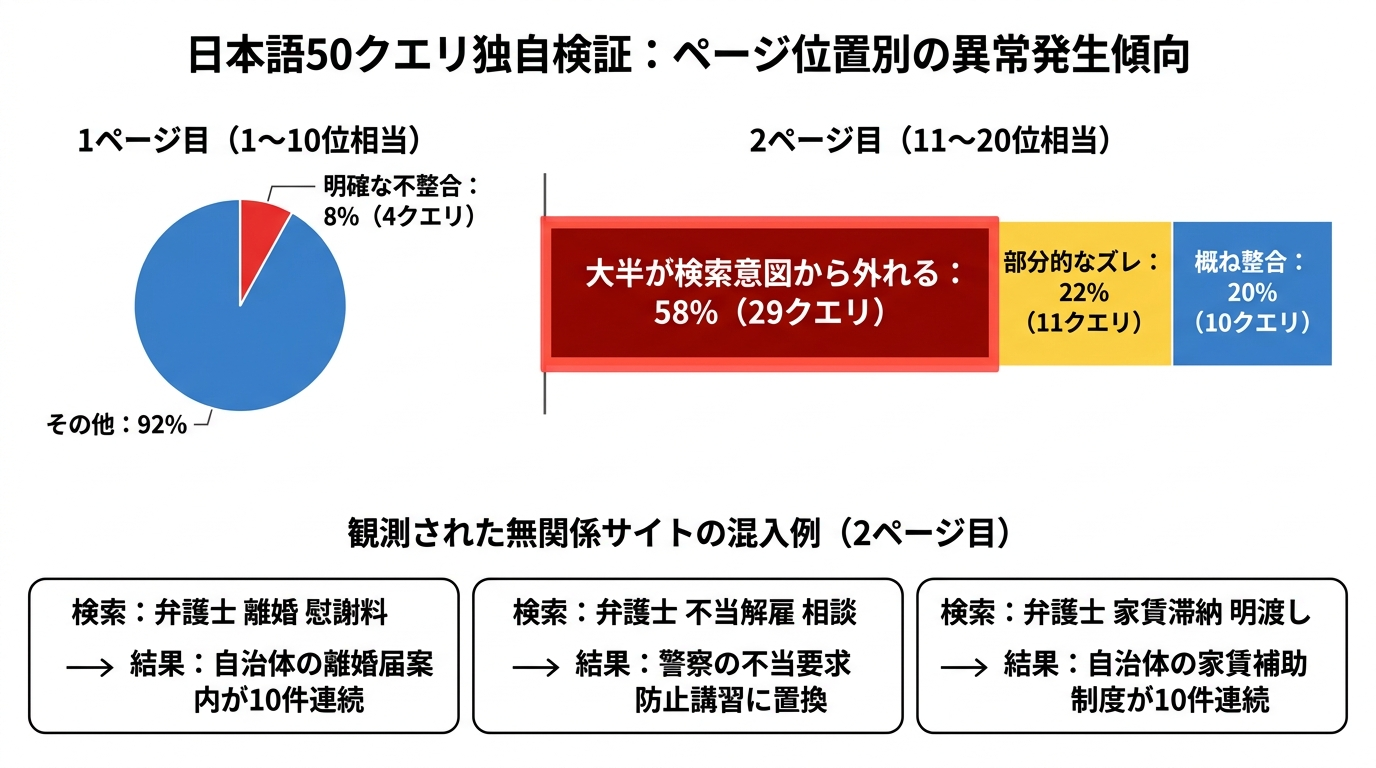
| 1ページ目(start=0/1〜10位相当) | 4/50件(8%) | 残る46件(92%)では明確な不一致を確認せず |
| 2ページ目(start=10/11〜20位相当) | 29/50件(58%) | 部分的なずれ11件(22%)、概ね整合10件(20%) |
1ページ目で明確な不一致が見られたのは4クエリ(8%)であったのに対し、2ページ目では50クエリ中29クエリ(58%)で結果の大半が本来の検索意図から外れており、部分的なずれ(22%)を含めると8割のクエリで異常が生じるという、2ページ目に異常が集中する傾向が確認されました。
「弁護士 離婚 慰謝料」で自治体の離婚届が10件連続
具体的な取得データを見ると、複合キーワードの一部の単語だけに反応したような極端な入れ替わりが起きています。
- 「弁護士 離婚 慰謝料」(2ページ目):1ページ目には離婚・慰謝料を扱う法律事務所が並んだものの、2ページ目には三重県伊賀市の「離婚届」や長野県塩尻市の「離婚届を提出する」など、自治体による離婚届の窓口案内が10件連続で返却された。
- 「弁護士 不当解雇 相談」(2ページ目):雇用や解雇の法律相談ではなく、「不当」の語に反応したと思われる暴力団対策(不当要求防止責任者講習など)のページが並んだ。
- 「弁護士 家賃滞納 明渡し」(2ページ目):オーナー側の法的明渡し手続きではなく、自治体の家賃補助制度の案内が10件連続で表示された。
- 「弁護士 相続人 行方不明」(2ページ目):不在者財産管理人や失踪宣告の解説ではなく、イタリア料理人のYouTubeチャンネルや外国人労働者の受け入れ支援情報が出現した。
異なるキーワード間での同一URLの反復出現と1ページ目の汚染
もう一つの顕著な特徴が、異なる検索キーワード間での「同一URLの使い回し(重複)」です。1ページ目の450件には444種類のURLが含まれ重複は延べ6件でしたが、2ページ目の500件は409種類のURLしかなく、重複が延べ91件に上りました。例えば、法務省の「ビジネス分野におけるAI等法務業務支援サービス提供」という同一のPDF資料が、財産分与、遺産分割、個人再生、自転車事故など、テーマの全く異なる10クエリの2ページ目に繰り返し登場しています。
さらに重要な点として、異常は2ページ目だけにとどまりません。1ページ目(上位10件)であっても、「弁護士 遺言書 無効」では弁護士検索や弁護士法などの一般情報ばかりが並び、「弁護士 退職勧奨 拒否」では退職所得課税や退職金共済のページが1ページ目を占めていました。つまり、上位10件のみを参照するシステムであっても、約8%(およそ12回に1回)の割合で汚染データに直撃するリスクがあるといえます。
※なお、今回の集計は外部ツール経由で取得した検索結果が元の検索意図と整合しているかを弊社が判定したものであり、8%や58%という数値をGoogle検索全体の「汚染率」とみなすことはできませんが、自動取得環境においてこうした不整合が実際に発生していることを示す重要な事実です。
SERP汚染がSEO実務やAI記事生成に及ぼす3つの悪影響
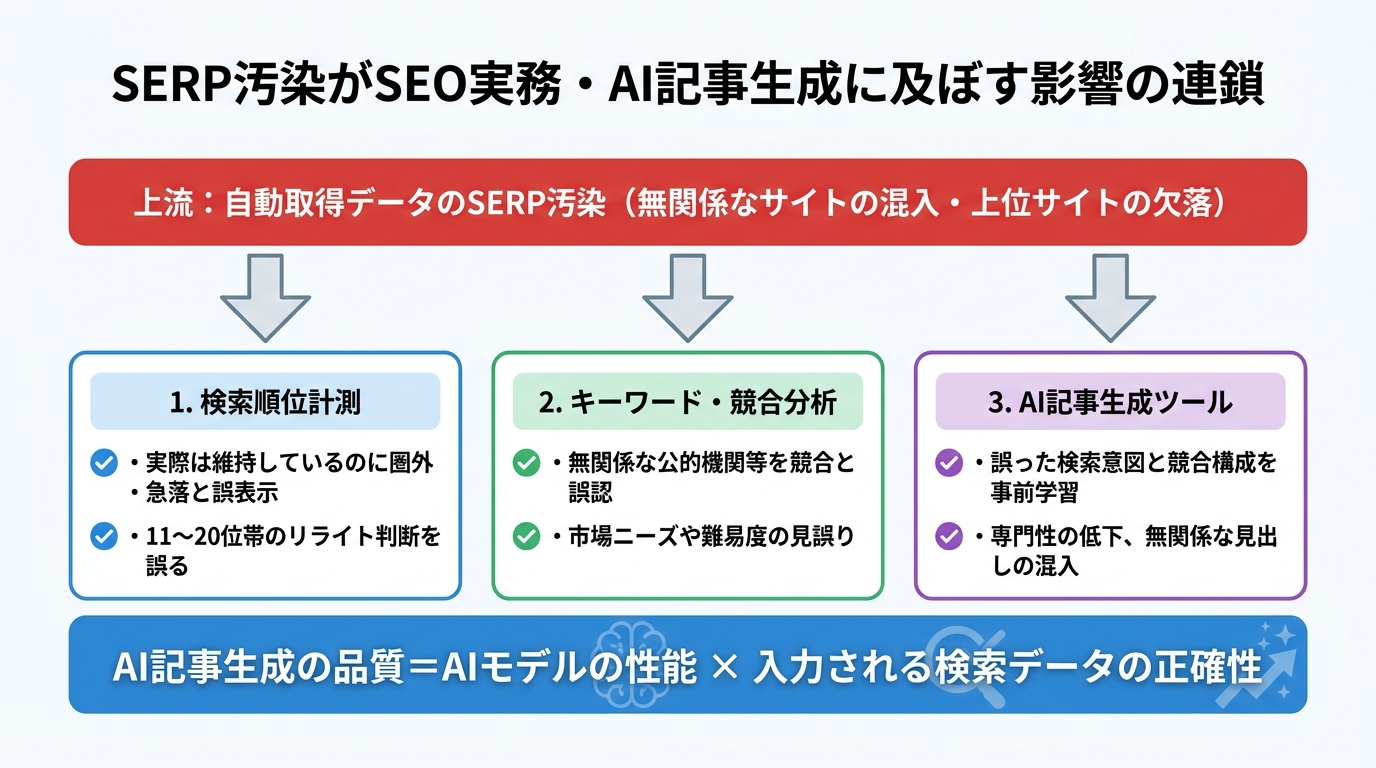
SERP汚染されたデータがそのまま各種マーケティングツールに取り込まれると、データ取得元(上流)の歪みが、分析やコンテンツ生成(下流)の誤りへと直結します。前章で確認した「2ページ目に集中する異常(58%)」と「1ページ目でも発生する異常(8%)」は、それぞれ以下の3つの実務領域に深刻な悪影響を及ぼします。
1. 検索順位計測ツールにおける「11位〜20位帯」の誤表示と誤判断
1つ目は、日々の定点観測に用いる検索順位計測ツール(ランクチェッカー)への影響です。実際のブラウザ検索では自社の記事が変わらず表示され、検索流入も維持されているにもかかわらず、ツールが自動取得したSERPが汚染されていたために、ツール上では「突然の圏外転落」や「数十位規模の急落」として記録されてしまいます。
特に弊社の検証で2ページ目(11位〜20位相当)の異常が58%に達していた点は、SEOの運用実務において致命的です。なぜなら、多くのWeb担当者は「現在11位〜20位につけている準上位の記事(あと少しで1ページ目に上がる記事)」をリライトの最優先候補として抽出し、施策後の効果を追跡するからです。
この11位〜20位帯の計測データがSERP汚染によって頻繁に欠落・乱高下すれば、正確な記事公開後の効果測定と改善サイクルを回すことができなくなり、順調に育っている記事を「順位が落ちた」と誤認して不要な改変を加えてしまうリスクが生じます。
2. キーワード分析・競合調査におけるベンチマークの誤認
2つ目は、新規コンテンツの企画やSEO戦略立案時に行うキーワード分析・競合調査への影響です。多くのSEO分析ツールは、対策キーワードの上位サイトを自動抽出し、見出し構成、文字数、共起語、ドメイン評価などを集計します。
この工程に汚染データが混入すると、「本来は競合ではない無関係な公的機関や別ジャンルのサイト」をベンチマーク対象として誤認識してしまいます。その結果、「公的機関や巨大ドメインばかりで一般企業には勝機がない」と誤った撤退判断を下したり、検索ユーザーが求めていない行政手続きの話題を必須トピックだと勘違いしたりするなど、競合分析から勝てる記事構成を作るプロセスそのものが入り口の段階で狂ってしまいます。
3. AI記事生成ツールにおける検索意図の誤解釈と構成案の崩壊
3つ目は、近年導入が進んでいる「SEO向けのAI記事生成ツール」への直接的な打撃です。生成AI(LLM)単体で文章を書かせる場合、AIモデルの知識カットオフによる情報の古さが課題となるため、本格的なAIライティングツールは執筆前にリアルタイムのGoogle検索結果(SERP)を自動取得し、上位ページの傾向から検索意図と構成案(見出し)を設計するなどで対策します。
ここで問題になるのが、1ページ目(上位10件)だけでも約8%の確率で発生するSERP汚染、および上位20件まで取得するツールにおける2ページ目の高確率な汚染データの混入です。
どれほど推論能力の高い最新のAIモデルを搭載していても、入力される前提データ(SERP)が汚染されていれば、出力される記事の構成も大きく歪みます(Garbage In, Garbage Out)。例えば、前章の実例のように「遺言書 無効」で弁護士法の一般情報ばかりが取得されたり、「離婚 慰謝料」で自治体の離婚届案内が大量に混入したりしたデータをそのままAIに参照させれば、法律相談の記事であるにもかかわらず「役所の窓口での届出手順」や「助成金の申請方法」といったピント外れな見出しが自動生成され、記事の専門性や信頼性(E-E-A-T)が根本から損なわれてしまいます。
SERP汚染に対するOGAIの防衛機構と利用ツールの確認点
AI記事生成の品質やSEO分析の精度は、単に「どの最新AIモデル(LLM)を採用しているか」だけで決まるものではありません。「分析の土台となる検索データ(SERP情報)の汚染をいかに検知・排除できているか」という前段のデータ品質制御が決定的な差を生みます。
最後に、今回のSERP汚染問題に対する私ども株式会社アップラボの対応状況をご報告するとともに、読者の皆様が現在利用されている各種ツールに関して確認すべき実務上のポイントをまとめます。
OGAIは独自の「SERP品質検証・自動再取得アルゴリズム」を実装済み
当社が開発・提供しているWordPress専用AIライティングツール「OGAI」では、1記事の執筆ごとに複数の検索クエリでGoogleのSERP情報を取得し、上位サイト(最大48万文字相当)を徹底分析したうえで構成案の作成と執筆を行うアーキテクチャを採用しています。
2026年夏以降のGOTOリンク導入および9月以降のSERP汚染を受け、OGAI開発チームでは前章の独自検証を通じて汚染データの発生パターンを解析し、汚染された検索結果がAIの分析パイプラインに混入するのを防ぐ独自の「SERP品質検証アルゴリズム」をすでに実装・稼働させております。
具体的な判定パラメータや内部ロジックの詳細は技術保護の観点から非公開としておりますが、システム内で以下の3段階の品質ゲートを自動実行しています。
- 中核語(コア概念)に基づく関連性バリデーション:
取得した自然検索結果(タイトルおよびスニペット)の1件ずつに対し、記事の主題となる中核語や関連表現が含まれているかを解析し、クエリ全体の有効合致率をリアルタイムで算出します。 - 汚染検知時のキャッシュ破棄と自動再取得(リトライ制御):
一部の単語だけに反応した無関係なサイト群(合致率の基準未達)を検知した場合、そのデータを即座に汚染(ダミーSERP)と判定し、キャッシュを無効化(no_cache)したうえで正常な検索結果が得られるまで自動的に再取得を実行します。 - 異常データの完全隔離:
万が一、複数回の再取得を経ても基準を満たさないクエリがあった場合は、その異常データを競合分析の対象から自動的に切り離し、健全性が確認されたSERPデータのみを用いて構成案を設計します。
この防衛機構により、現在OGAIはSERP汚染の影響を受けることなく、本来の正確な検索結果データに基づいた検索意図分析・競合分析・記事生成が正常に稼働しております。現在OGAIをご利用中の企業様・士業事務所様におかれましては、どうぞ安心して日々のコンテンツ制作にご活用ください。
利用中のSEOツール・AI記事生成ツールで確認すべき3つのポイント
もし貴社において、検索順位計測ツール、キーワード・競合分析ツール、あるいは他社のAI記事生成ツールなどを日常業務で利用されている場合は、SERP汚染によるデータの歪みに巻き込まれないよう、以下の3点を確認されることを推奨します。
1. 不自然な順位急落や見慣れない競合は「実際の検索画面」と照合する
順位計測ツール上で「昨日まで11位〜15位だった記事が突然圏外になった」「競合分析ツールで見覚えのない自治体ページや無関係なジャンルのサイトが上位候補として並んでいる」といった違和感に遭遇した場合は、ツールの数値をそのまま鵜呑みにせず、ブラウザのシークレットモードで実際に同じキーワードを検索し、実際の検索画面との間に乖離がないかを目視で照合してください。
2. AI生成記事の「構成案」に無関係なトピックが混ざっていないか確認する
SERPを参照するタイプの他社AIライティングツールを使用している場合、生成された見出し構成や本文の中に、検索クエリの一部の単語だけに引きずられた不自然なトピック(例:法律相談のテーマなのに行政の窓口手続きや助成金の話が混じるなど)が含まれていないかを確認してください。公開前のAIライティングにおけるファクトチェックと確認項目として、個別の事実の正誤だけでなく「構成全体が本来の検索意図からズレていないか」を点検することが不可欠です。
3. 利用しているツール提供元の認識とSERP汚染対策の有無を確認する
現在契約・利用されている各SEOツールやAIツールの提供元(ベンダー)が、2026年7月以降のGOTOリンク問題や9月以降のSERP汚染問題を認識し、取得データの品質検証やクレンジング対策を実施しているかを確認することをおすすめします。
なお、SERP汚染への対策アルゴリズムをはじめ、事前ファクトチェックや20業種の法規チェック、図解・内部リンクの自動生成までをWordPress内で完結できる弊社のプラグイン「OGAI」については、初回ユーザー様向けに20日間の無料トライアルをご用意しております。正確な競合分析に基づく高品質なAI記事制作をご検討中の方は、ぜひ実際のWordPress環境でお試しください。