AIライティングの注意点|専門記事で公開前に必ず確認すること
AIライティングツールを用いて法律や医療、BtoBサービスなどの専門記事を作成した際、指示した覚えのない「30代女性の相談事例」や「導入企業A社の成功体験談」が本文中に突如として出力され、戸惑った経験はないでしょうか。
もっともらしい具体的なエピソードが並んでいるものの、自社にはそのような実績も記録も存在しない。このまま公開すれば、Googleからペナルティを受けたり、読者や業界から「虚偽の情報を載せている」と信頼を失ったりするのではないか――。多くのオウンドメディア担当者や専門職の方々が、このような強い危機感と迷いを抱えています。
結論から申し上げますと、AIが勝手に作り出した実在しないエピソードを「事実の体験談」としてそのまま公開することは、SEO評価とコンプライアンスの両面において極めて危険な行為です。しかし一方で、複雑な専門知識を読者に噛み砕いて伝えるための「架空のモデルケース(例え話)」まで一律に排除する必要はありません。
本記事では、AIライティングエージェント「OGAI」の開発責任者であり、長年にわたり士業や専門領域のWeb集客・コンプライアンス支援に携わってきた専門家の視点から、AIが体験談を捏造する技術的メカニズムと、現場で迷わないための「捏造」と「許容される架空事例」の明確な境界線、そして公開前に必須となる実在確認の手順を体系的に解説します。
なお、士業や医療など専門領域におけるAIライティングの全体像と安全な運用工程については、専門領域におけるAIライティングの安全な運用工程で体系的に解説していますので、あわせて参考にしてください。
なぜAIは専門記事で架空の体験談を捏造するのか
人間がプロンプト(指示文)で「嘘の体験談を書いて」と命じたわけではないのに、なぜAIはさも実在するかのような相談事例や顧客エピソードを出力してしまうのでしょうか。
まずは、この現象がAIの単なるバグ(不具合)ではなく、大規模言語モデル(LLM)の確率的な文章生成の仕組みと、SEO記事作成におけるプロンプトの指示内容が重なって生じる現象であることを理解する必要があります。
具体性を求める指示が架空エピソードを生む仕組み
ChatGPTやGeminiをはじめとする大規模言語モデルは、データベースから正確な事実を検索して貼り付けているわけではありません。入力された指示(プロンプト)の文脈に続く「もっとも確率的に自然で、人間が納得しやすい言葉の並び」を予測し、次々と繋ぎ合わせることで文章を生成しています。
専門記事を作成する際、担当者は読者にとって有益な記事にしようと「初心者にもわかりやすく書いてください」「具体例を交えて解説してください」といった指示を与えがちです。するとAIは、事前学習した膨大なWeb上のテキストデータの中から「説得力のある専門記事の型」を再現しようと試みます。
学習データ内の優れた専門記事には、具体的な人物像や課題解決のストーリーが多く含まれています。そのため、AIは「具体例を求められた=具体的な人物の悩みと解決のエピソードを出力するのが最適解である」と確率的に判断し、年齢・職業・相談内容・解決結果を組み合わせた架空の体験談を自動合成してしまうのです。
AI自身には「その事例が現実世界に実在するかどうか」を検証する意識はありません。こうしたAIの嘘や事実無根の出力を防ぎ、根拠ある情報源に回答を縛るためのRAGとGroundingの技術的仕組みを理解しておくことは、専門メディアを安全に運用する上で欠かせない基礎知識となります。
E-E-A-T重視のトレンドが招く「経験」の模倣
もう一つの要因として、近年のSEOにおけるGoogleの評価基準と、それを受けた記事制作の指示傾向が挙げられます。Googleは検索品質評価ガイドラインにおいて、従来のE-A-T(専門性・権威性・信頼性)に「Experience(経験・実体験)」を加えたE-E-A-Tを重視しています。
この流れを受け、現在Web上で上位表示されている多くの記事には、「私自身も過去に〜」「当事務所にご相談いただいたB様は〜」といった一次情報や実体験の記述が豊富に盛り込まれるようになりました。その結果、AIの事前学習データにそうした記事群が含まれることに加え、生成時に競合上位記事の構成を参照させたり、市販のSEO向けプロンプトで「一人称の体験談や自社事例を盛り込むように」と誘導したりすることで、架空の経験記述が誘発されやすくなっているのです。
書き手である企業や専門家が自らの一次情報をAIに与えないまま「SEOに強い記事を書いて」と指示を出せば、AIは空白となっている「経験」のパーツを埋めるため、もっともらしい一人称のエピソードを模倣・捏造して出力します。AIに丸投げするのではなく、人間側の実体験を適切に組み込むE-E-A-Tを高める編集テクニックを取り入れなければ、一次情報の不足や生成結果の確認漏れによって架空の経験記述が原稿内に残ってしまいます。
「体験談の捏造」と「許される架空事例」の定義と境界線
AIが出力した原稿の中に、実在しないエピソードが含まれていた場合、それらをすべて削除しなければならないのでしょうか。もしそうであれば、専門的で難解な法律や医療、BtoBの仕組みを、具体的なイメージを持たせながら読者に解説することが非常に難しくなってしまいます。
ここで重要になるのが、「架空の話」がすべて悪なのではないという専門的な視点です。私たちが厳格に区別すべきなのは、読者や検索エンジンを欺く「体験談の捏造」と、専門知識をわかりやすく伝えるための「架空のモデルケース」、そして実在の事例を保護するための「匿名化・デフォルメ」の3つです。
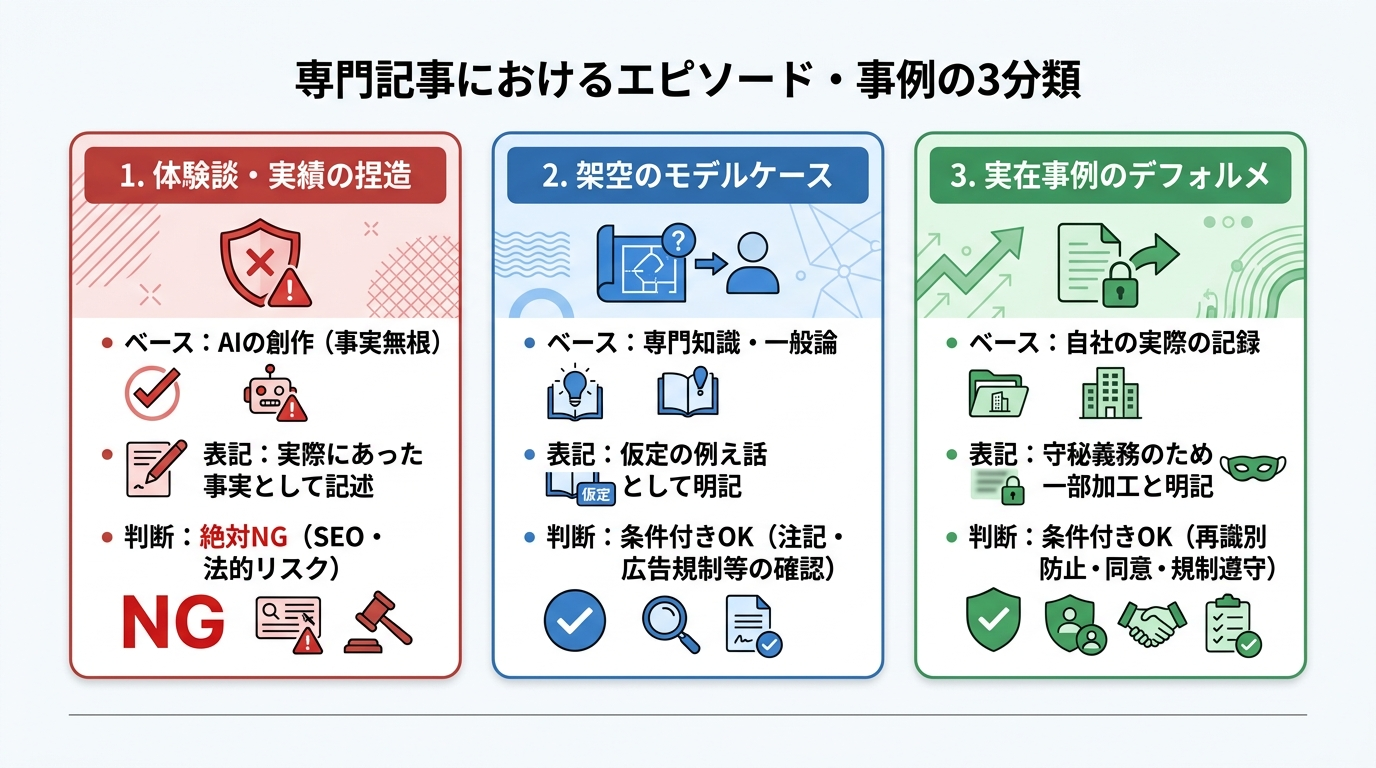
手元の原稿に含まれるエピソードがどのカテゴリーに該当し、どう扱うべきかを判断できるよう、以下の表にそれぞれの定義と境界線を整理しました。
| 分類カテゴリー | 定義と情報のベース | 読者への見せ方(表記) | 掲載の可否と主なリスク |
|---|---|---|---|
| 1. 体験談・実績の捏造 | 実在しない架空の話を、自社の実績や実体験であるかのように装うこと(ベース:ゼロ/AIの創作) | 「先日ご相談いただいたA様は〜」「実際に導入したB社では売上が2倍に〜」と事実として記述 | 絶対NG検索評価の低下やスパム措置、景品表示法(優良誤認)、業法違反、信用の失墜 |
| 2. 架空のモデルケース | 専門知識や制度の適用条件を理解しやすくするための仮定のシミュレーション(ベース:専門知識・一般論) | 「たとえば、このような条件のケースを想定してみましょう」と仮定の例え話として明記 | 条件付きでOK仮定である旨の明示と専門的妥当性に加え、各業種の広告規制や効果誤認のない表現であることが条件 |
| 3. 実在事例のデフォルメ | 実際にあった相談や導入実績について、個人や企業が特定されないよう属性等を一部加工したもの(ベース:自社の一次情報) | 「過去にご相談いただいた事例(※守秘義務に配慮し一部加工しています)」と加工の旨を添えて記述 | 条件付きでOK(推奨)他情報との照合による再識別の防止、必要に応じた本人・顧客の同意、守秘義務および業種別広告規制の遵守が条件 |
それぞれの境界線について、さらに詳しく掘り下げていきます。
絶対NGな「体験談・実績の捏造」とは何か
専門記事において絶対に許されない「捏造」とは、実在しない顧客の声、架空の相談解決実績、実際には試していない製品レビューなどを、あたかも「実際にあった事実(一次情報)」であるかのように記述する行為を指します。
ここで多くの担当者が陥りやすいのが、「書かれている法律の解釈や、業務改善のロジック自体は専門的に正しいのだから、エピソードが架空でも問題ないのではないか」という錯覚です。しかし、問題の本質は専門知識の正否ではありません。「存在しない経験を、存在した事実として読者に提示し、自社の信頼性や実績を不当に高く見せかけていること」自体が虚偽表示にあたるのです。
人間と検索エンジン(AI)の双方に対して誠実であるためには、根拠のない情報を事実のように装う手法を排し、AIをだまさない安全なGEO対策の原則に基づいた品質管理を徹底する必要があります。
専門記事で許容される「架空のモデルケース」の定義
一方で、複雑な税制の計算シミュレーションや、労働トラブルの法的判断基準、医療における一般的な制度や仕組みなどを解説する際、「たとえば、勤続10年でこのような状況にあるAさんを想定してみましょう」といった『例え話(モデルケース・ケーススタディ)』を用いることは、専門記事において読者の理解を助ける有益な手法となり得ます。
この「架空のモデルケース」が実在事例の捏造と混同されないための前提条件は、「読者が実在事例と誤認しないよう、仮定表現と視認できる注記で示すこと」にあります。
「当事務所が解決した事例」として語るのではなく、「一般論を具体的なシチュエーションに当てはめたシミュレーション」として提示されていれば、事実と偽ることにはなりません。ただし、架空であると明記することだけで掲載の適法性がすべて保証されるわけではありません。AIが生成した架空のエピソードをモデルケースとして掲載する際は、仮定である旨の明示と専門的見地からの妥当性に加え、掲載媒体の広告該当性、医療や士業などの業種別広告規制、そして成果や治療効果に対する誤認を招かないかを確認した上で判断する必要があります。
守秘義務を守る「実在事例のデフォルメ」との違い
さらに実務上よく混同されるのが、実在する事例をベースにした「デフォルメ(匿名化・抽象化)」です。弁護士や税理士、医師、BtoBコンサルタントなどの専門職が、実際の相談事例や顧客カルテを一切の加工なしにWeb上で公開すれば、個人情報保護法違反や各業法が定める守秘義務違反に直結します。
そのため、実際の現場では「42歳・製造業勤務・男性」という実在の相談者を「40代・会社員」と丸めたり、複数の類似した相談事例の要素を統合して一つの典型例として再構成したりする加工が行われています。これは元となる記録が自社の実体験に根ざしているため、AIがゼロから作り出した「捏造」とは明確に異なります。ただし、単なる属性の一部変更は法令上の「匿名加工情報」とは異なるものであり、他の情報と照合することで本人を識別できる場合は依然として個人情報に該当します。そのため、属性の加工と注記だけでよしとせず、再識別の可能性がないか、公開にあたって本人や顧客の同意が必要か、守秘義務に抵触しないかを個別に確認しなければなりません。
また、デフォルメを行う際にも表現上の一線は存在します。「課題の本質」や「解決に至ったプロセス」、そして「結果(成果の数値など)」を事実以上に誇張して書き換えてしまえば、それはデフォルメの範疇を超えて「捏造(優良誤認)」へと変質します。さらに、医療領域における患者の体験談など、実在の事例であっても広告としての掲載自体が禁止されている業種もあります。特に士業などの専門領域においては、弁護士広告規程を踏まえた生成AI活用術でも解説している通り、事実に合致しない表示や依頼者を誤導するおそれのある加工は厳しく制限されているため、業種別の広告規制を遵守した上で、変更するのは「特定を防ぐための属性情報や背景の一般化」にとどめるのが安全な実務基準です。
捏造した体験談の公開が招くSEOと信用の重大なリスク
「AIが書いた体験談だけれど、自然な文章だし、わざわざ調査されなければバレないだろう」「もし検索順位が下がったら、その時に該当箇所を消せばいい」――もし社内にそのような楽観的な意見があるとしたら、直ちに認識を改める必要があります。
捏造された体験談や紛らわしい架空事例をそのまま公開することは、該当記事の検索評価を損なうだけでなく、法令や業界規制への違反、さらには顧客や取引先からの信用失墜といった重大なリスクを招きます。
Googleが求める独自の「経験」とAI生成記事の品質評価
Googleの検索品質評価において、人間が読むと一見自然に見える「AIが作ったもっともらしい体験談」は、本来の評価対象である独自の一次情報とは明確に区別されます。
第一に挙げられるのが、「経験(Experience)を裏付ける具体的な一次情報の欠如」と「コンテンツの独自性評価」です。人間が実際に体験した事象を語る際、そこには「特定の状況下で発生した具体的な数値」「現場特有の判断の経緯」「予定通りにいかなかった際の対応」といった、実務に基づく具体的な文脈が含まれます。
一方、AIが捏造した体験談は、学習データ内の多くの記事から統計的にもっともらしい展開を合成した一般的なストーリーに過ぎません。Googleには、ユーザーが既に閲覧した文書に対してどれだけ新しい追加情報があるかを評価する「インフォメーション・ゲイン(情報増分)」に関する特許技術などもありますが、検索ランキングの基本仕様として公に重視されているのは、既存のWeb情報の焼き直しではない「独自の価値や一次情報(E-E-A-T)が含まれているか」という点です。どこかで見たような予定調和のエピソードは、読者に新たな価値を提供する独自の「経験」としては評価されにくいのが実情です。
第二に、発信者の信頼性(E-E-A-T)の評価です。なお、Googleの「SynthID」のような電子透かし技術はAI生成物であることを識別するための技術であり、記述されている体験談の真偽そのものを直接判定するものではありません。しかし、Googleの検索品質評価ガイドラインでは、コンテンツの内容だけでなく、サイト運営者がどのような実績や専門性を持つ主体であるかという信頼性が重視されます。実態の伴わない解決実績を記事内で語っていても、確かな一次情報としての裏付けがなければ、検索エンジンが求める本質的な品質基準を満たすことはできません。検索エンジンが重視する品質評価の考え方については、AIライティングに対するGoogleのSEO評価基準で詳しく紐解いています。
また、Google自身がAI生成コンテンツの品質をどのように捉えているかについては、公式の発表もあわせて確認しておくことを推奨します。検索順位を操作することだけを目的とした低品質な自動生成への厳しい姿勢が明記されています。
参考:Google検索セントラル「AI生成コンテンツに関するGoogle検索のガイダンス」
スパム判定の条件とサイト評価への影響
AIによる偽の体験談や、独自の価値が伴わない記事を大量に生成・公開した場合、検索評価への悪影響が生じる懸念があります。Googleのコアランキングシステムにおける品質評価や、スパムポリシーにおける「スケールされたコンテンツの悪用(Scaled Content Abuse)」の対象となるリスクがあるためです。
Googleのランキング評価は基本的にページ単位で行われますが、同時にサイト全体のシグナルも評価の一部として使用されます。サイト全体が低評価だからといってすべてのページが一律に順位を落とすわけではありませんが、検索エンジンを操作する目的で独自の価値がない記事を大量に作成していると判断された場合、サイト全体のシグナルが個別の専門記事やサービスページの評価にも関係し、手動対策(ペナルティ)やアルゴリズムによる順位低下を招くおそれがあります。
品質の問題によって低下した評価が改善後に回復するまでの期間は、改善の内容や検索エンジンによる再評価の状況によって異なり、数日で反映される場合もあれば数ヶ月を要する場合もあります。こうした評価低下やスパム判定のリスクを回避し、品質と量を高次元で両立させるための具体的なアプローチは、AI記事量産の罠と独自知見を活かす新戦略をご参照ください。
景品表示法や業界の広告規制に抵触する法的リスク
SEO上のペナルティ以上に深刻であり、絶対に看過できないのが、現実世界における法的リスクと社会的信用の失墜です。
架空の成功事例や捏造された顧客の体験談を事実であるかのようにWebサイトに掲載し、自社のサービスや商品の効果をアピールする行為は、景品表示法における「優良誤認表示(第5条第1号)」に該当する可能性が極めて高いと言えます。実際よりも著しく優良であると一般消費者に誤認させる表示に対しては、消費者庁からの措置命令や課徴金納付命令といった厳しい行政処分が下されます。
ここで特に注意すべきは、「記事の最後に小さく『※個人の感想です』『※イメージです』と書いておけば免責される」という誤った認識です。消費者庁のガイドラインにおいて、本文の強調表示(「導入して売上が急増しました!」などの体験談)と矛盾するような小さな打消し表示は、消費者が正しく認識できないため無効(不当表示のまま)とみなされることが明確に定められています。
さらに、専門職には各業界固有の厳しい広告規制が存在します。
- 医療領域(医療広告ガイドライン):患者の主観に基づく体験談や、治療内容・効果に関する感想を医療機関のWebサイトに掲載することは、原則として全面的に禁止(誘引性のある広告における虚偽・誇大広告等の禁止)されています。実在する患者の声であってもNGである以上、AIが生成した架空の患者エピソードの掲載は論外です。
- 士業領域(弁護士・司法書士・税理士等の広告規程):「事実に合致しない広告」や「依頼者を誤導するおそれのある広告」は各士業会の規程で厳格に禁じられています。架空の解決事例を実績のように載せることは懲戒処分の対象となり得ます。
企業ブログやオウンドメディアを公開するにあたって必ず押さえておくべき法務面のチェックポイントは、企業ブログで注意したいAIライティングの7つの法律リスクで網羅的に解説しています。また、打消し表示が法的にどう判断されるかについては、消費者庁が公開している以下の公的資料も一読しておくことを強くお勧めします。
参考:消費者庁「打消し表示に関する留意点」(PDF)
公開前に必須!体験談の実在確認と架空事例の掲載判断
ここまでの解説で、AIが捏造した体験談を放置することの危険性と、「モデルケース」との境界線が明確になったかと思います。では、実際にAIが出力した専門記事のドラフトを目の前にしたとき、担当者はどのような手順で確認を行い、どのように修正・加工すればよいのでしょうか。
ここからは、記事を公開する直前に現場でそのまま実践できる「実在確認のフロー」と、架空事例について仮定である旨の明示や専門的妥当性の確認、広告規制への適合を行うための具体的な編集手順を解説します。なお、YMYL領域全般における公開前の総合的な安全基準については、YMYL領域でAI記事を公開する前のチェックリストもあわせてご活用ください。
記事内の「体験談・相談事例」を洗い出す実在確認手順
AIが生成した原稿のファクトチェックというと、統計データや法改正の年月日といった「客観的な数値・事実の確認」にばかり目が行きがちです。しかし、専門記事においてはそれと同等以上に「エピソード・相談事例の実在確認」を独立した工程として組み込む必要があります。
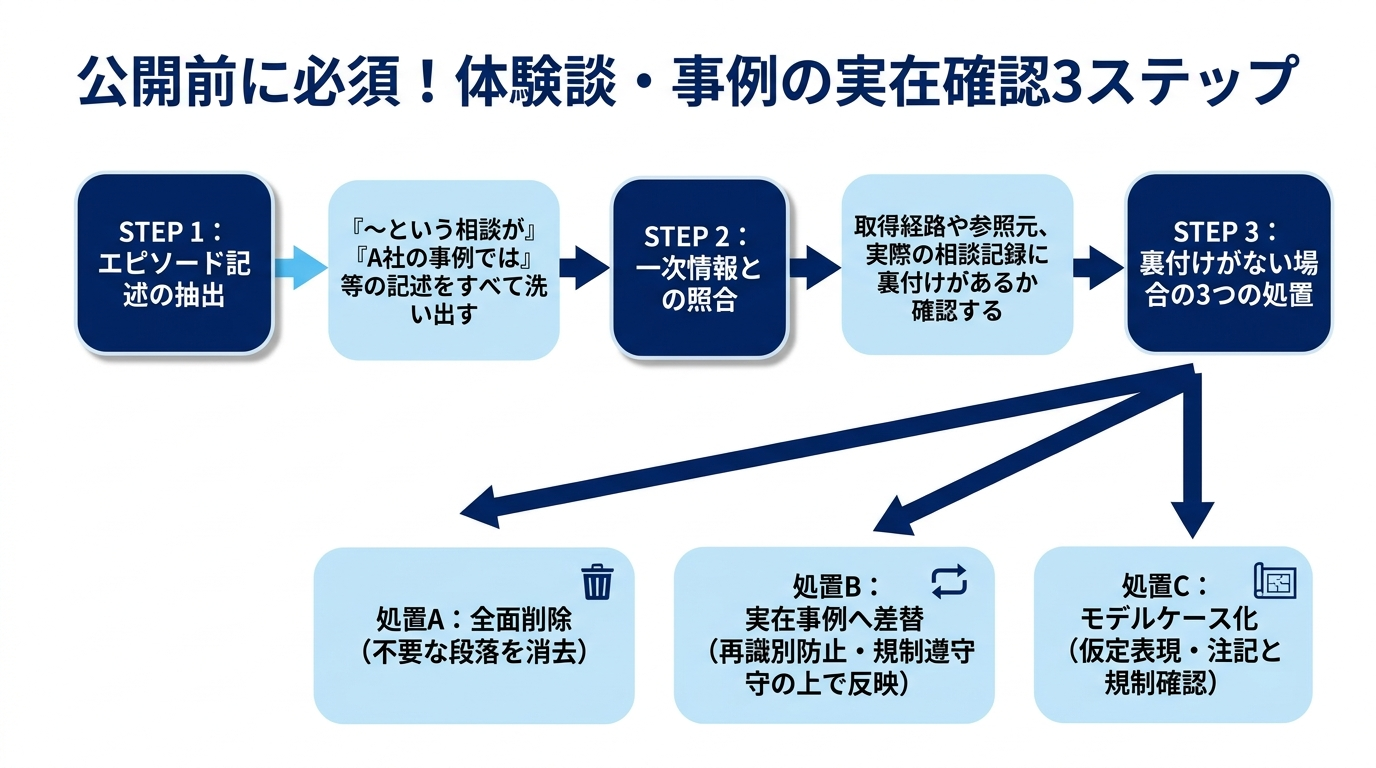
公開前の実在確認は、以下の3つのステップで機械的かつ確実に実行してください。
- エピソード記述の全面抽出(シグナルワード検索):
まず、原稿内から体験談や事例を示唆する特有のフレーズ(シグナルワード)をすべて洗い出します。具体的には、「〜というご相談がありました」「実際に試したところ〜」「A社(Bさん)の事例では〜」「私自身も過去に〜」「よくあるケースとして、先日〜」といった記述をマーカー等でハイライトします。 - 自社の一次情報(裏付け)との照合:
抽出したそれぞれのエピソードについて、「これは執筆前に人間がAIに与えた社内の一次情報(実際の顧客カルテ、相談記録、議事録、担当者の実体験メモ)に基づいているか?」を照合します。プロンプトに直接入力していないエピソードが出力されている場合は、すべて未確認情報として抽出し、検索機能やRAG(外部資料参照)、事前学習データなどによる取得経路や参照元の有無、そして自社の実際の記録と一致するかを精査します。ここで、AIが確率的に合成した架空の創作である場合だけでなく、実在する第三者の公開事例を自社の実績であるかのように誤って帰属させている場合も厳密に区別し、自社の裏付けがない事例を事実として公開しないよう徹底します。 - 3つの処置方針からの選択:
自社の記録としての裏付けが存在しないエピソードに対しては、曖昧なまま残すことをせず、必ず以下の3つの処置のいずれかを適用します。- 処置A【全面削除】:そのエピソードがなくても前後の論理展開が成立する場合は、該当段落を完全に削除する。
- 処置B【実在事例への差し替え】:自社の過去の相談記録や実績データを確認し、守秘義務や再識別の防止、必要に応じた同意取得、業種別の広告規制に配慮した上で、実際にあった類似のエピソードに書き換える。
- 処置C【モデルケースへの書き換え】:読者の理解を助ける「例え話」として残した方が有益であると判断した場合、専門的妥当性や業種別の広告規制・効果誤認の有無を確認した上で、次項で解説するルールに従って「仮定のシミュレーション」へと表現を修正する。
このように人間とAIの役割を明確に分け、効率的に原稿の正確性を検証する仕組みづくりについては、AIと人間が協業するファクトチェック体制の構築法でも実践的なステップを提案しています。
架空事例を「モデルケース」として安全に掲載する書き方
前項のステップ3において「処置C:読者の理解を助けるために、架空のモデルケース(例え話)として残す」と判断した場合、どのように文章を修正すれば「捏造」にならず、読者にも検索エンジンにも誠実さが伝わるのでしょうか。
鍵となるのは、「仮定表現への徹底的な統一」と「明瞭な注記の配置」、そして「効果や成果を断定・誇張しない表現」です。以下に、AIが出力しがちな危険なNG表現と、安全に掲載できるOK表現の具体的な対比を示します。
| 比較項目 | NG表現(事実の体験談として捏造) | OK表現(仮定のモデルケースとして誠実に提示) |
|---|---|---|
| 導入の切り出し方 | 「先日、当事務所にご相談に来られた30代会社員のBさんは、残業代の未払いに悩んでいました。」 | 「たとえば、30代の会社員で、以下のような残業代の未払い状況にあるケースを想定してみましょう。」 |
| プロセスの描写 | 「私たちがタイムカードの記録を調査し、会社側と交渉した結果、わずか1ヶ月で解決しました。」 | 「このような状況では、一般的にタイムカード等の客観的証拠を揃えた上で会社側と交渉を進めるという解決アプローチが考えられます。」 |
| 結末と注記 | 「最終的に150万円の回収に成功し、Bさんからは『もっと早く相談すればよかった』と感謝の言葉をいただきました。」 | 「適切な手順を踏むことで、未払い分の請求・回収を進められる場合があります(実際の結果は個別の状況や証拠の有無により異なります)。※上記のケースは、制度や手続きの理解を助けるために設定した架空のモデルケース(シミュレーション)であり、特定の実在する相談事例ではありません。」 |
書き換えのポイントは4つあります。第一に、「先日〜来られた」「実際に〜した」といった架空の出来事を実際に起きた事実として語る表現を排除し、「たとえば〜を想定してみましょう」「〜と仮定します」という仮定のフレームワークに置き換えること。第二に、架空の顧客に「感謝のセリフ(口コミの捏造)」を喋らせないこと。第三に、消費者庁の打消し表示ルールに配慮し、読者が本文を読む流れの中で自然に目に入る位置(該当ブロックの直前または直後)に、本文と同じ文字サイズ・視認性で「理解を助けるための架空のモデルケースである」と明記すること。そして第四に、そのシミュレーション内容が専門的に妥当であり、医療や士業などの業種別広告規制に抵触せず、特定の成果や治療効果が確実に得られるかのような誤認を与えないかを確認することです。
難解な専門知識をこうした具体的なモデルケースに落とし込み、一般の読者にも直感的に伝わるよう工夫するアプローチは、AIで専門用語を平易化し伝わる文章にリライトする技術と組み合わせることで、さらに高いUX(ユーザー体験)を生み出します。
社内の断片的な実体験メモをAIで誠実に成形する手順
最後に、SEO評価において重要となる、E-E-A-Tの「Experience(経験)」を適切に反映するアプローチをお伝えします。それは、AIにゼロから事例を作らせるのではなく、社内に蓄積されている「断片的な実際の記録(一次情報のメモ)」を人間が用意し、AIにはその「整形と一般化」を担当させるという役割分担です。
なお、実際の相談記録や顧客情報をAIに入力する前には、必ず人間側で氏名・社名などの個人情報や秘密情報を除去・最小化し、利用するAIサービスの学習利用の有無、データの保存期間、契約条件、および必要に応じた本人の同意等を事前に確認しておく必要があります。AIに送信した後で匿名化を指示すれば十分というわけではない点に注意してください。
専門職や現場の担当者がゼロから長文の事例記事を書こうとすると膨大な時間がかかりますが、事前に個人情報や機密情報を除いた箇条書きのメモであれば短時間で用意できるはずです。たとえば、以下のような断片的なメモで構いません。
【人間が用意する一次情報メモの例(※入力前に特定情報を除去したもの)】
- 相談者の属性:製造業を営む中小企業(従業員30名規模)の社長
- 当初の課題:勤怠管理が紙のタイムカードで、毎月の集計に丸2日かかっていた。法改正への対応も不安だった。
- 提案・実施したこと:クラウド勤怠システムの導入支援と、就業規則の一部見直しを実施。
- 現場での注意点(独自の知見):高齢の社員が多くスマホ操作に強い抵抗感があったため、最初はICカード打刻機を併用するハイブリッド運用にしたのが成功のポイントだった。
- 結果:集計作業が月2時間程度に短縮された。
このような実際の記録を用意した上で、AIに対して以下のような制約条件(プロンプト)を与えて文章化させます。
【事実を捏造させず誠実に成形するプロンプトの指示ルール】
「上記の箇条書きメモ(当社の実際の支援記録から特定情報を除いたもの)のみを事実の根拠として使用し、専門記事内の事例紹介セクションを作成してください。
【厳守事項】
1. メモに記載されていない数値、期間、劇的なエピソード、顧客のセリフ等を勝手に追加・脚色(創作)することは絶対に禁止します。
2. 守秘義務およびプライバシー保護のため、他の情報と照合しても特定の企業や個人が識別されないよう、出力時の属性表現も適切に一般化(抽象化)してください。
3. 読者が自社の状況に置き換えて理解できるよう、論理的で丁寧な解説調でまとめてください。」
この手順を踏むことで、ハルシネーションによる捏造リスクを大幅に低減しつつ、「高齢社員への配慮としてICカード打刻を併用した」という自社の記録で実在を裏付けられる現場の一次情報を含んだ、信頼性の高い専門記事を効率的に作成できます。ただし、制約付きのプロンプトを用いてもAIの誤生成リスクを完全にゼロにできるわけではないため、生成された文章と元の記録を人間が最終的に照合する工程は必須です。こうした人間とAIの適切な役割分担については、一次情報のインプットでAI記事を差別化する協業術でさらに詳しく解説しています。
なお、私たちが開発・提供しているWordPressプラグイン型AIライティングツール「OGAI」でも、まさにこの設計思想をシステムレベルで実装しています。記事作成の最初のステップにおいて、担当者が「テーマ」とともに「実体験などの一次情報(メモレベルで可)」を入力できる専用フィールドを設けており、入力された独自の知見をもとに構成案の作成から本文執筆、さらには20業種に対応したコンプライアンスチェックやファクトチェックまでを全自動で実行します。最初から「人間の一次情報」を起点にしてAIを動かし、最終確認を行うワークフローを確立することが、捏造リスクを抑える実践的な解決策となります。
まとめ:誠実な事例判断が専門メディアの信頼を築く
本記事では、AIライティングを用いた専門記事制作において多くの担当者が直面する「体験談の捏造リスク」と「架空事例の掲載判断」について、技術的背景から法的リスク、そして具体的な実務フローまでを解説しました。最後に、記事公開前に必ず振り返っていただきたい重要なポイントを整理します。
- AIが体験談を捏造する理由:AIは悪意を持って嘘をついているのではなく、「具体例を入れて」「SEOに強い記事を」といった指示や参照情報に対し、学習データ内の「説得力のある記事の型(経験記述など)」を確率的に模倣・自動合成してしまう性質があります。
- 3つのカテゴリーの境界線:実在しない話を事実として語る「捏造」は絶対NGです。一方、理解を助けるための仮定のシミュレーションである「架空のモデルケース」や、実際の事例を保護のために加工した「デフォルメ」は、仮定・加工の明示や再識別の防止、必要に応じた同意確認、および各業種の広告規制や効果誤認の防止といった条件を満たすことで、有益なコンテンツとして活用できます。
- 放置することの重大なリスク:捏造された体験談は、独自の一次情報としての価値を欠き検索評価の低下やスパム措置の対象となり得るだけでなく、景品表示法(優良誤認)や医療・士業等の広告規制に抵触する深刻なコンプライアンス違反となります。
- 公開前の実在確認と誠実な対策:公開前に必ず原稿内のエピソード記述を洗い出し、自社の記録としての裏付けがないものは「削除」「条件を満たした実在事例への差し替え」「仮定表現と注記・広告規制への配慮を用いたモデルケースへの書き換え」のいずれかを行ってください。
生成AIは、これまで数時間から数日かかっていた専門記事の制作プロセスを劇的に短縮してくれる強力なパートナーです。一方で、出力された記述を元の記録と照合し、法規制や事実関係に照らして公開可否の最終判断を担うのは公開責任者である人間の役割です。AIの出力を統括し、品質とコンプライアンスを最終的に担保する新時代の「AI編集者」としての役割と業務フローを社内に定着させ、公開前の確認工程を継続的に運用していくことが、専門メディアの信頼性を守る確かな基盤となります。